Indra OCR 1.1: GPU'suz, 1 Milyon Parametreli OCR Değer mi?
Indra OCR 1.1, 1 milyon parametreyle GPU'suz çalışıyor; hız, doğruluk, dil desteği ve lisans koşullarını sayılarla anlatıyoruz.
İçindekiler 12
Indra OCR 1.1, Datalab'in yaklaşık 1 milyon parametreli ana modele sahip OCR motorunun yeni sürümü ve GPU gerektirmeden yalnızca CPU üzerinde çalışıyor. Sürüm 19 Ekim 2026'da yayımlandı. El yazısı, 80'den fazla dil ve döndürülmüş sayfa desteği geldi. Kod ücretsiz; model ağırlıkları için lisans koşulları var.
Kısaca:
- Indra OCR 1.1, GPU istemeyen, yaklaşık 1 milyon parametreli bir OCR motoru.
- 32 çekirdekte yaklaşık 44 sayfa/saniye, 4 çekirdekte yaklaşık 210 ms/sayfa hız veriyor.
- El yazısı skoru 8,3'ten 25,2'ye çıktı, ancak Datalab bunu hâlâ zayıf buluyor.
- Model ağırlıkları, 20 milyon dolardan az fonlu ya da gelirli girişimler için ücretsiz.
Indra OCR nedir ve ne işe yarar?
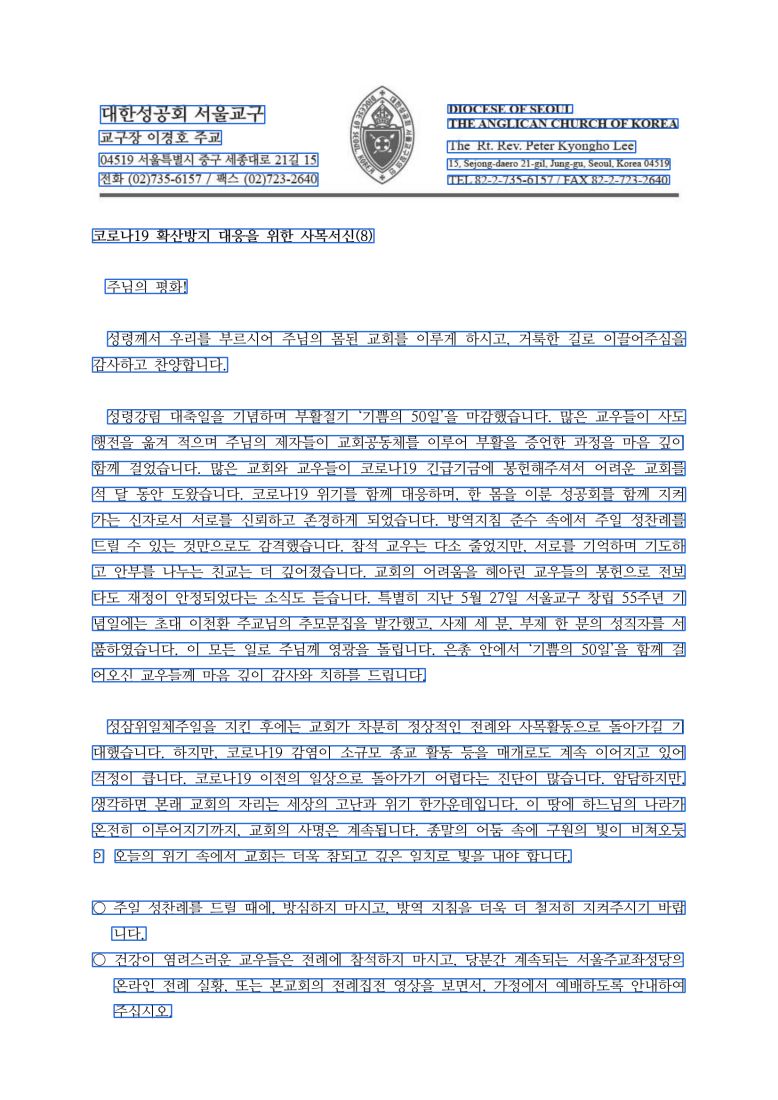
OCR, görüntü ya da taranmış belgedeki yazıyı makinenin okuyabileceği metne çevirme işidir. Fatura, sözleşme, form ve arşiv belgesi işleyen her işletme bir noktada bu ihtiyaçla karşılaşır. Indra OCR bu iş için Datalab'in geliştirdiği, küçük ve hızlı bir motordur.
Ana modeli yaklaşık 1 milyon parametreden oluşuyor. Bu, büyük görsel-dil modellerinin yanında çok küçük bir boyut. Küçük boyutun getirisi doğrudan ortada: model GPU olmadan, sıradan sunucu işlemcilerinde çalışıyor. Kurulum da basit: pip install indra-ocr komutu yetiyor ve Python 3.10 veya üzeri gerekiyor. Ayrıntılar PyPI sayfasında ve Datalab'in sürüm yazısında yer alıyor.
1.1 sürümünde neler değişti?
Sürüm, 13 Ekim'de çıkan 0.3'ün ardından 19 Ekim 2026'da yayımlandı. Datalab'in blog yazısına ve haberin özetine göre ana yenilikler şunlar:
- El yazısı tanıma
- 80'den fazla dil desteği
- Döndürülmüş sayfaları okuma
- OmniParseBench üzerinde başlık, tablo ve metin skorlarında artış
Aşağıda sayıları tek tek karşılaştırıyoruz.
0.3'e göre ne kadar iyileşti?
OmniParseBench, belge ayrıştırma kalitesini ölçen bir test seti. Başlık skoru 0.3'te 62,3 iken 1.1'de 66,7 oldu. --math seçeneğiyle bu skor 67,0'dan 71,4'e çıkıyor. Tablo skoru da 56,3'ten 61,1'e yükseldi.
| Indra OCR 1.1 (--math) | 71,4 |
|---|---|
| Indra OCR 1.1 | 66,7 |
| Indra OCR 0.3 (--math) | 67,0 |
| Indra OCR 0.3 | 62,3 |
Kaynak: Datalab
Genel tabloda her sürüm geçişinde 4-5 puanlık bir artış görülüyor. Bunun yanında iki özel yetenekte daha büyük sıçrama var:
- Döndürülmüş sayfalar: Skor %25,3'ten %50,3'e çıktı. Yani sayfa eğik ya da yan taranmış olsa bile okuma kalitesi iki katına yaklaştı.
- El yazısı: Skor %8,3'ten %25,2'ye çıktı.
El yazısı desteği ne kadar güvenilir?
Kısa cevap: henüz değil. El yazısı skoru üç kat arttı, ama Datalab bu sonucu kendisi "hâlâ zayıf" olarak tanımlıyor. %25,2, el yazısı formları ya da not defterlerini otomatik işleyecek bir sistem için yeterli değil.
Bu yüzden el yazısı, bugün için bir bonus özellik sayılmalı. Üretim hattınızın merkezine el yazısı okumayı koyacaksanız, kendi örnek belgelerinizle test yapmadan karar vermeyin. Basılı metin ve tablo tarafı ise çok daha olgun.
Indra OCR ne kadar hızlı?
Hız, bu motorun en dikkat çekici yanı. PyPI sayfasındaki resmi rakamlar şöyle:
- 32 CPU çekirdeğinde yaklaşık 44 sayfa/saniye
- 4 çekirdekte yaklaşık 210 ms/sayfa
- OmniParseBench medyan süresi: otomatik modda 212 ms, yalnız OCR modunda 344 ms,
--mathile 357 ms
Tesseract kıyası da aynı sayfada: tek iş parçacığında Tesseract sayfa başına 3,4 saniye harcıyor. Geliştiricinin duyurusunda Tesseract'a karşı 15 kat hız iddiası öne çıkıyor. Bu iddiayı bağımsız olarak denemek isteyen biri tam benchmark'ı kendi Mac Studio'sunda çalıştırdığını ve doğruluğun duyurulan değerle yaklaşık 0,2 puan farkla örtüştüğünü, ancak Tesseract karşısında hız farkının 3 kat civarında kaldığını paylaştı. Donanıma ve ayara göre fark değişebilir. Kendi sunucunuzda ölçmeden büyük bir hız vaadine güvenmeyin.
Doğruluk açısından rakiplerle durumu nedir?
Resmi karşılaştırmada Indra OCR, açık kaynak alternatiflerin önünde:
Başlık skorunda da Indra OCR 66,7 puanla, 58,4 alan PaddleOCR PP-StructureV3 tam hattının önünde. Üstelik bu skorları 1 milyon parametreli bir model alıyor. Metin tanıma Tesseract'a göre iki katından fazla puan topluyor.
Buradaki ders, model boyutunun tek başına belirleyici olmadığı. Geliştiricinin duyurusuna göre ana model, 3,4 milyar parametreli DeepSeek OCR 2'nin OmniParseBench skorundan yalnızca yaklaşık 4 puan geride kalıyor. Boyut farkı ise kabaca üç binde bir.
Hangi dilleri okuyor?
README'de 95 dil ölçülmüş. Bunların 83'ünde karakter F1 skoru en az 0,90, 67'sinde ise en az 0,95. Karakter F1, okunan karakterlerin ne kadarının doğru olduğunu ölçer; 0,95 üstü, çoğu iş için güvenilir sayılır.
Türkçenin bu listede olup olmadığını elimizdeki kaynaklar açıkça söylemiyor. Türkçe belge işleyecekseniz, özellikle ı, İ, ş, ğ gibi karakterlerde, kendi örneklerinizle küçük bir doğrulama testi yapın. Bu karakterlerin yazılımları nasıl bozabildiğini Türk İ problemi yazımızda ele almıştık.
Lisans: kim ücretsiz kullanabilir?
Lisans iki parçalı:
- Kod: Ücretsiz.
- Model ağırlıkları: Araştırma, kişisel kullanım ve 20 milyon dolardan az fon ya da gelire sahip girişimler için ücretsiz.
Bu, küçük ve orta ölçekli işletmelerin çoğunu kapsıyor. Ancak büyüyen bir şirketseniz, eşiği aştığınız noktada ticari lisans gerekebilir. Bu koşulu ürün planınıza baştan yazın. Girişimlere sunulan benzer desteklerle ilgileniyorsanız girişim destek programları rehberimize de bakabilirsiniz.
Indra OCR kimler için uygun?
Şu durumlarda mantıklı bir aday:
- GPU maliyeti ödemek istemeyen ve sıradan sunucularda belge işleyen ekipler.
- Fatura, form ve sözleşme gibi basılı belgeleri toplu işleyenler.
- Tablo ve başlık yapısını da çıkarmak isteyenler; model satır konumlarını ve okuma sırasını da veriyor.
- Tesseract'tan daha doğru ama bulut OCR servisleri kadar pahalı olmayan bir çözüm arayanlar.
Şu durumlarda temkinli olun:
- İşinizin merkezinde el yazısı varsa, %25,2 skor yetmez.
- Çok karmaşık, düzensiz belgelerde büyük modeller hâlâ daha iyi sonuç verebilir.
- Lisans eşiğine yaklaşıyorsanız ticari koşulları netleştirin.
Sıkça sorulan sorular
Indra OCR GPU gerektiriyor mu?
Hayır. Yaklaşık 1 milyon parametreli ana model CPU üzerinde çalışıyor. 4 çekirdekte sayfa başına yaklaşık 210 ms, 32 çekirdekte yaklaşık 44 sayfa/saniye hız veriyor.
Indra OCR nasıl kurulur?
pip install indra-ocr komutuyla kurulur. Python 3.10 veya üzeri gerekir. Güncel sürüm 1.1.2 olarak PyPI'da yayımlı.
El yazısını güvenle okuyabilir mi?
Henüz değil. El yazısı skoru %8,3'ten %25,2'ye çıksa da Datalab sonucu "hâlâ zayıf" olarak tanımlıyor. Basılı metinde çok daha güçlü.
Ticari projede kullanabilir miyim?
Kod ücretsiz. Model ağırlıkları, 20 milyon dolardan az fonlu ya da gelirli girişimler için ücretsiz. Bu eşiğin üstündeki şirketler lisans koşullarını Datalab'den teyit etmeli.
Sonuç
Indra OCR 1.1, "iyi OCR için büyük model gerekir" varsayımına karşı güçlü bir örnek: 1 milyon parametre, GPU'suz çalışma ve açık kaynak rakiplerin önünde skorlar. El yazısı tarafı hâlâ olgunlaşmadı, ama basılı belge ve tablo işlemede ciddi bir seçenek. Karar vermeden önce kendi belgelerinizle küçük bir deneme yapmak en sağlıklı yol.
EngerekTech olarak belge işleme, OCR entegrasyonu ve işletmeye özel yazılım projelerinde ekiplere destek veriyoruz. Kendi belgeleriniz için doğru aracı seçmek isterseniz bizimle iletişime geçebilirsiniz.
Kaynaklar
 DatalabIndra OCR 1.1: handwriting, 80+ languages and pages at any angleIndra OCR 1.1 reads handwriting, OCRs 80+ languages on scans, and straightens pages at any angle. OmniParseBench headline 71.4 with --math, still on CPU.pypi.orgClient Challengepasqualepillitteri.itIndra OCR 1.1 launches with 80+ languages and handwriting, all on CPUXVik ParuchuriIndra OCR 1.1 is out now!
- 1M param main OCR model, 44 pages/s on CPU
- Within 4 points of 3.4B param DeepSeek OCR 2 on OmniParseBench
- 15x faster than Tesseract, and more accurate
- 80+ languages, plus handwriting pic.twitter.com/SL4jU0ou9cXTheOyinbookeDatalab says Indra OCR, its 1M-parameter model, reads 49 pages a second on CPU and is 17x faster than Tesseract.
I ran their full benchmark, all 2,937 pages, on my Mac Studio.
The accuracy matched to within 0.2 points. Against Tesseract, it was 3x faster, not 17x.
Full results,… https://t.co/kgTo4kKUWU